Pedidos de servidores de IA en México acumulan hasta siete meses de espera
Servidores para IA en México tardan hasta siete meses, frente a seis u ocho semanas antes. Qué implica para el costo por token y la inversión en data centers.
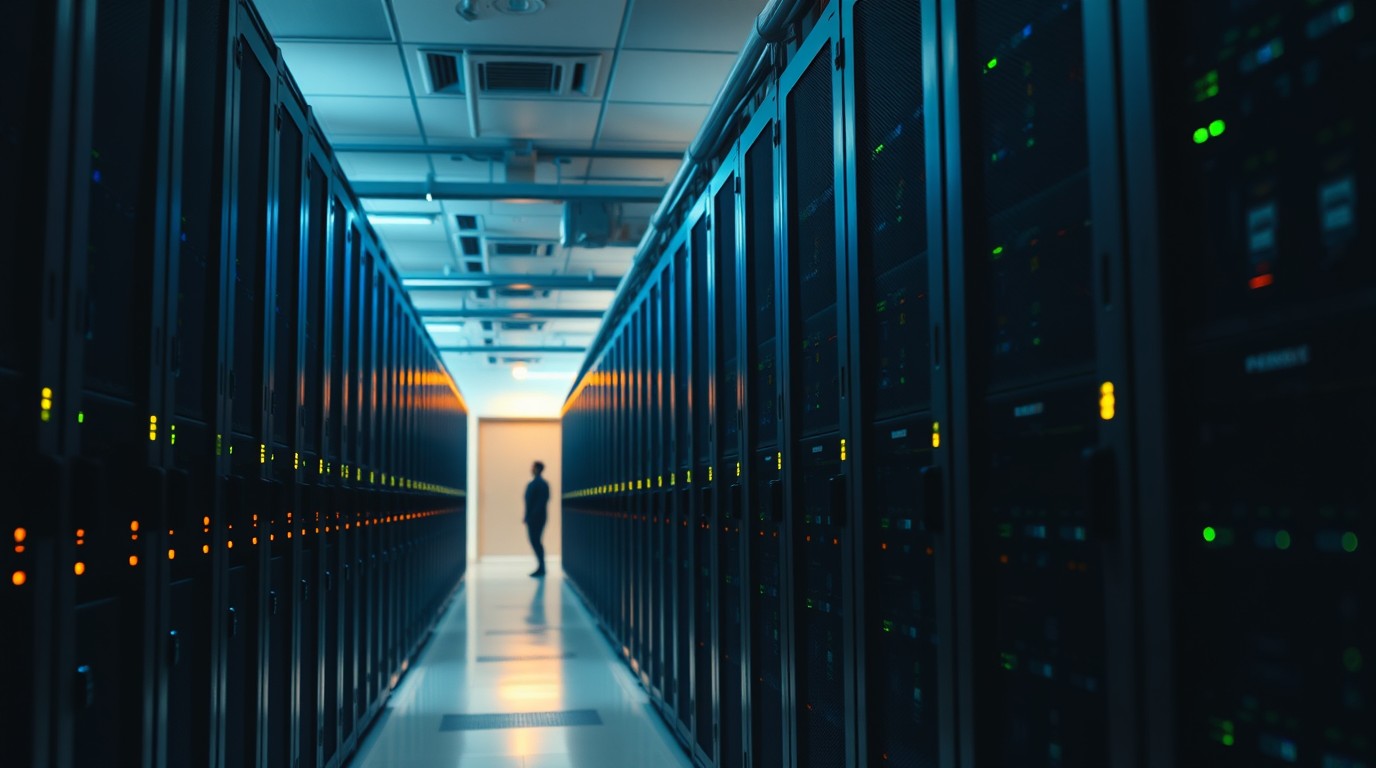
Los pedidos de servidores para inteligencia artificial en México tardan hasta siete meses, unas 30 semanas, frente a las seis u ocho semanas habituales, según El Financiero del 11 de noviembre de 2026. Esteban Rey, director general de Ignia, dijo que una orden de compra reciente le cotizó ese plazo para llegar al país.
El cuello de botella no es local. La escasez de unidades de estado sólido, memoria y procesadores gráficos (GPU) golpea la cadena global, y los fabricantes priorizan a los hiperescaladores, que compran por volumen y pagan primas. Expansión documentó en octubre que Moody's estima un gasto de capital de 700,000 millones de dólares de los hiperescaladores estadounidenses para 2026, seis veces lo invertido en 2022. El mismo reporte ubica a la inteligencia artificial como el tercer sector con más inversión de capital privado en México, detrás de fintech y comercio electrónico, según Amexcap. Para una empresa mexicana que planea desplegar cómputo propio, el plazo de entrega se vuelve una variable de planeación tan importante como el precio del equipo.
Rey precisó que los equipos menos sofisticados pueden tardar entre 16 y 18 semanas. Carlos Sánchez, director de Desarrollo de Negocios de Qualcomm para Hispanoamérica, señaló que más de 90% de las actividades sobre los modelos grandes serán de inferencia, el procesamiento que ocurre en cada consulta. Sánchez describió un centro de datos de inferencia como una fábrica de tokens cuyo costo depende, entre otros factores, de la energía utilizada. Por eso el indicador que empieza a pesar es cuántos tokens se generan por watt y cuánto cuesta cada millón de tokens. Sánchez afirmó que, si los costos se vuelven más eficientes, «México podría concentrar alrededor de la mitad de la inversión prevista en centros de datos para inferencia en América Latina, sin considerar a Brasil».
El dato deja sobre la mesa dos variables que ahora pesan en la decisión: el rezago de entrega y el costo por consulta. La pregunta operativa ya no es qué modelo usar, sino a qué costo por token se puede sostener la operación.
Esta nota fue redactada con asistencia de inteligencia artificial a partir de fuentes verificadas y revisada por un editor humano antes de publicarse.